Q 학습(Q-learning)은 정답 행동을 미리 알려 주지 않아도 시행착오로 행동의 가치를 배우는 강화학습 방법입니다. 현재 상태에서 행동을 선택하고 그 결과로 받은 보상과 다음 상태를 기록하면서 조금씩 판단을 고칩니다.
이 설명만으로는 한 가지가 선뜻 이해되지 않습니다. 목표에 도착하는 마지막 이동에서만 보상을 받는다면, 출발점에서 한 선택은 어떻게 좋아질까요? Q 학습의 핵심은 다음 상태에 이미 기록된 값을 이용해 지금 선택한 행동의 값을 고치는 것입니다.
gymnasium-playbook 저장소에 있는 FrozenLake 풀이 코드를 통해 Q 학습의 작동 과정을 확인해 보겠습니다.
Q 학습이 풀려는 문제
강화학습에서는 프로그램을 에이전트(agent)라고 부릅니다. 에이전트는 환경을 관찰하고 행동한 뒤 그 결과를 돌려받습니다. 한 번의 상호작용에는 네 가지 정보가 있습니다.
| 이름 | FrozenLake에서는 | 하는 일 |
|---|---|---|
| 상태(state) | 현재 서 있는 칸 | 지금 어떤 상황인지 나타냅니다. |
| 행동(action) | 왼쪽, 아래, 오른쪽, 위 | 현재 상태에서 선택할 수 있는 움직임입니다. |
| 보상(reward) | 목표 도착은 1, 나머지는 0 | 환경이 방금 행동의 결과로 돌려주는 숫자입니다. |
| 다음 상태(next state) | 이동한 뒤 도착한 칸 | 다음 판단이 시작되는 상황입니다. |
이 네 가지는 상태 → 행동 → 보상과 다음 상태의 순서로 반복됩니다. 출발해서 목표에 도착하거나 구멍에 빠질 때까지 이어지는 한 번의 시도를 에피소드(episode)라고 합니다.
에이전트는 눈앞의 보상만 보지 않고 지금부터 에피소드가 끝날 때까지 받을 보상의 합을 크게 만드는 행동을 찾습니다. 먼 미래의 보상에는 할인율(discount factor)을 거듭 곱해 조금 작게 셉니다. 이렇게 계산한 미래 보상의 합을 수익(return)이라고 합니다.
Q 학습은 환경의 이동 규칙을 표로 받아 경로를 계산하지 않습니다. 직접 행동하고 얻은 경험만으로 배웁니다. 다음 상태가 어디일지, 보상이 얼마일지 미리 계산하는 환경 모델이 필요 없다는 의미에서 모델 없는(model-free) 방법입니다.
Q 값은 무엇을 뜻할까?
Q 학습은 모든 상태, 행동 쌍에 숫자 하나를 붙입니다. 이를 행동 가치(action value) 또는 Q 값(Q-value)이라고 합니다. 상태 $s$에서 행동 $a$를 한 뒤 가장 좋은 행동들을 이어 간다고 가정해 보겠습니다. $Q(s, a)$는 이때 앞으로 받을 할인된 수익의 추정값입니다.
보상과 Q 값은 자주 헷갈리는 개념이지만 뜻은 다릅니다.
- 보상은 환경이 이번 이동 직후 돌려주는 실제 값입니다.
- Q 값은 이번 이동 뒤에 이어질 미래까지 생각한 수익의 추정값입니다.
따라서 지금 보상이 0이어도 Q 값은 0보다 클 수 있습니다. 목표로 이어지는 길에 있다는 사실을 앞선 경험에서 배웠다면, 당장 보상을 받지 못한 행동도 가치가 있습니다. 반대로 큰 즉시 보상을 받아도 그 뒤에 더 큰 손해가 이어지는 문제라면 Q 값은 낮아질 수 있습니다.
Q 값만 있으면 행동을 고르는 규칙도 만들 수 있습니다. 현재 상태에 속한 Q 값 가운데 가장 큰 값을 찾아 그 행동을 선택하면 됩니다. 이렇게 상태마다 행동을 고르는 규칙을 정책(policy)이라고 합니다. Q 학습의 결과물은 경로 자체가 아니라 좋은 정책을 꺼낼 수 있는 Q 값들입니다.[1][2]
FrozenLake가 Q 학습을 이해하기 좋은 이유
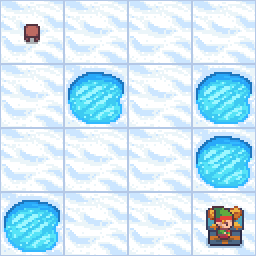
FrozenLake 실행 화면. 파란 구멍을 피해 오른쪽 아래의 선물까지 이동합니다.
이 글에서 사용하는 지도는 가로와 세로가 각각 4칸입니다. 왼쪽 위에서 출발해 상하좌우로 움직이며 구멍에 빠지면 실패하고 오른쪽 아래 목표에 도착하면 성공합니다. 이번 구현에서는 100번 움직여도 끝나지 않으면 그 에피소드를 중단합니다.
FrozenLake에서는 Q 학습의 주요 개념을 살펴볼 수 있으며 계산도 손으로 따라갈 수 있습니다.
| 특징 | Q 학습을 이해하는 데 도움이 되는 이유 |
|---|---|
| 상태 16개, 행동 4개 | 모든 Q 값을 16 × 4 표 하나에 담을 수 있습니다. |
| 상태와 행동이 이산적임 | 신경망이나 함수 근사 없이 각 값을 따로 저장할 수 있습니다. |
| 현재 칸이 완전히 관찰됨 | 같은 칸 번호가 앞으로의 이동과 보상을 판단하는 데 필요한 정보를 담습니다. |
| 목표와 구멍이 있는 에피소드 | 성공과 실패의 끝이 분명해 종료 상태의 갱신을 설명하기 쉽습니다. |
| 목표에서만 받는 보상 | 멀리 있는 보상이 앞선 상태로 전해지는 모습을 볼 수 있습니다. |
| 짧은 최단 경로 | 학습한 정책이 합리적인지 직접 세어 확인할 수 있습니다. |
FrozenLake의 기본 설정에서는 얼음 위를 미끄러질 수 있습니다. 오른쪽을 선택해도 다른 방향으로 이동할 수 있다는 뜻입니다. 이 구현에서는 값이 전달되는 순서를 분명히 확인하기 위해 is_slippery=False로 설정합니다. 선택한 방향으로 정확히 이동하며 지도 밖으로 나가려 하면 제자리에 머뭅니다. 환경 설정 코드에서 이 조건을 확인할 수 있습니다.
미끄러짐을 끈 4×4 지도는 Q 학습의 입문 예제로는 좋지만 현실 문제를 대표하지는 않습니다. 상태가 많아지면 표의 크기도 빠르게 커지고 한 번도 방문하지 않은 상태의 값은 알 수 없습니다. 화면처럼 연속적인 입력이나 아주 큰 상태 공간에서는 신경망으로 Q 값을 근사하는 방법이 필요합니다. 현재 관찰에 필요한 정보가 빠져 있는 문제라면 같은 상태에서도 올바른 행동이 달라질 수 있어 상태를 구성하는 방법부터 다시 생각해야 합니다.
미끄러운 환경에서는 같은 행동도 여러 결과를 만들기 때문에 각 Q 값은 여러 경험의 평균에 가까워지고 더 많은 시도가 필요합니다. 목표 보상이 1이고 나머지가 0인 FrozenLake에서 할인율까지 1이라면 Q 값은 성공 가능성과 비슷하게 해석할 수 있습니다. 이 구현처럼 할인율이 1보다 작으면 성공 가능성뿐 아니라 목표까지 걸리는 이동 횟수도 함께 반영하므로 Q 값을 그대로 성공 확률이라고 부를 수는 없습니다.
64개의 숫자로 정책 만들기
프로그램은 화면의 그림 대신 현재 칸의 번호를 상태로 받습니다. 왼쪽 위부터 차례대로 매긴 0~15 중 하나를 받습니다. 각 칸에서 선택할 행동은 왼쪽, 아래, 오른쪽, 위의 네 가지입니다.
그래서 Q 표(Q-table)의 크기는 16 × 4, 총 64개 숫자입니다. 한 행은 현재 칸을, 네 열은 그 칸에서 선택할 방향을 나타냅니다.
| 현재 상태 | 왼쪽 | 아래 | 오른쪽 | 위 |
|---|---|---|---|---|
| 어떤 칸 $s$ | $Q(s, \text{왼쪽})$ | $Q(s, \text{아래})$ | $Q(s, \text{오른쪽})$ | $Q(s, \text{위})$ |
학습 전에는 모든 값을 0으로 둡니다. 어느 행동이 좋은지 모른다는 뜻입니다. 경험을 하나 얻을 때마다 방금 선택한 상태, 행동 칸 하나를 갱신합니다. 학습이 끝난 뒤에는 현재 행에서 가장 큰 값을 가진 행동을 고릅니다. 표의 생성과 학습 반복 코드는 이 과정을 그대로 담고 있습니다.
Q 값은 어떻게 고칠까?
한 번 이동해서 상태 $s$, 행동 $a$, 보상 $r$, 다음 상태 $s’$를 얻었다고 하겠습니다. Q 학습은 먼저 방금 경험이 가리키는 목표값(target)을 만듭니다.
\[\begin{aligned} \text{목표값} &= \text{이번 보상} + \text{할인율} \times \text{다음 상태에서 가장 큰 Q 값} \\ &= r + \gamma \max_{a'} Q(s', a') \end{aligned}\]$\max_{a’} Q(s’, a’)$는 다음 상태에서 가능한 행동들의 Q 값 가운데 가장 큰 값입니다. 실제로 다음 행동을 하기 전이라도 현재 표에서 가장 좋은 행동을 고른다고 가정합니다. 이번 보상에 그 뒤로 기대하는 수익을 더한 값이 지금 행동의 목표값입니다.
이는 벨만 최적 방정식(Bellman optimality equation)을 한 번의 경험에 적용한 형태입니다. 가장 좋은 Q 값은 이번 보상 + 다음 상태에서 얻을 수 있는 가장 좋은 값과 맞아야 하며, 학습이 진행될수록 표의 값은 이 관계에 가까워집니다.
목표값을 계산했다고 현재 Q 값을 곧바로 덮어쓰지는 않습니다. 현재 추정과 목표값의 차이를 구하고 학습률(learning rate)만큼만 다가갑니다.
\[\begin{aligned} \delta &= \text{목표값} - \text{현재 Q 값} \\ &= r + \gamma \max_{a'} Q(s', a') - Q(s, a), \\ Q_{\mathrm{new}}(s,a) &= Q(s,a) + \alpha\delta \\ &= Q(s,a) + \alpha\Bigl[ r + \gamma \max_{a'}Q(s',a') - Q(s,a) \Bigr] \end{aligned}\]괄호 안의 차이를 시간차 오차(temporal-difference error, TD error)라고 합니다. 한 단계 움직인 뒤 새로 만든 목표값을 방금 전까지 예상한 값과 비교한 차이입니다. 오차가 양수면 그 행동을 더 좋게, 음수면 덜 좋게 평가합니다.
이 구현의 학습률 $\alpha$는 0.1이고 할인율 $\gamma$는 0.99입니다. 따라서 새 목표로 한 번에 뛰어가지 않고 차이의 10%만 반영하며 다음 상태의 값은 99%만 현재로 가져옵니다.
목표에 도착하거나 구멍에 빠지면 에피소드가 끝납니다. 이후에 선택할 행동이 없으므로 목표값은 이번 보상 $r$뿐입니다. Q 값 갱신 코드를 설명에 필요한 부분만 줄이면 다음과 같습니다.
if terminated:
    target = reward
else:
    target = reward + discount * q_table[next_state].max()

q_table[state, action] += learning_rate * (target - q_table[state, action])
목표의 보상이 출발점까지 전해지는 과정
목표에 가까운 두 칸을 A와 B라고 부르고 A → B → 목표로 이동하는 경우만 떼어 보겠습니다. A와 B는 설명을 위해 붙인 이름입니다. 아직 목표에 한 번도 도착하지 않아 Q 표가 모두 0인 상태에서 아래 순서로 이동한다고 가정합니다. 실제 학습 기록이 아니라 온라인으로 값이 바뀌는 순서를 살펴보기 위한 예제입니다.
| 이동 순서 | 이번 보상 | 갱신할 목표값 | 이번에 고치는 Q 값 |
|---|---|---|---|
| 처음 A → B | 0 | B의 값도 모두 0이므로 $0 + 0.99 \times 0 = 0$ | A → B: $0 \rightarrow 0$ |
| 처음 B → 목표 | 1 | 목표에 도착했으므로 $1$ | B → 목표: $0 \rightarrow 0.1$ |
| 다시 A → B | 0 | B에 남은 값을 이용해 $0 + 0.99 \times 0.1 = 0.099$ | A → B: $0 \rightarrow 0.0099$ |
| 다시 B → 목표 | 1 | 목표에 도착했으므로 $1$ | B → 목표: $0.1 \rightarrow 0.19$ |
첫 번째 A → B 이동에서는 A의 값이 올라가지 않습니다. 그 시점에는 B의 네 행동도 모두 0이기 때문입니다. 다음 이동에서 목표에 도착하면 B → 목표의 Q 값이 0.1로 올라갑니다. 성공했다고 지나온 경로를 되짚으며 모든 값을 한꺼번에 바꾸지는 않습니다.
변화가 A까지 오는 것은 세 번째 이동입니다. 다시 A에서 B로 이동하면 B에 0.1이라는 값이 남아 있습니다. A에서 받은 보상은 여전히 0이지만 목표값은 $0 + 0.99 \times 0.1 = 0.099$가 됩니다. A → B의 값은 그 차이의 10%인 0.0099만큼 올라갑니다.
Q 학습은 이번 에피소드가 끝날 때까지 기다리지 않고 다음 상태에 기록된 추정값으로 현재 값을 고칩니다. 이미 추정한 값으로 다른 추정값을 갱신하는 방식을 부트스트래핑(bootstrapping)이라고 합니다.[1][3][4]
A보다 한 칸 앞의 값은 A → B가 0.0099로 바뀐 뒤 그 칸을 다시 방문할 때 올라갑니다. 같은 상태들을 여러 번 방문하고 한 단계씩 갱신하면서 목표 근처의 정보가 출발점까지 전해집니다. 할인율이 1보다 작으므로 같은 보상으로 이어지는 경로라면 더 적은 이동으로 도착하는 행동의 Q 값이 더 큽니다.
Q 학습이 시간차 학습(temporal-difference learning)인 이유도 여기에 있습니다. 에피소드가 끝난 뒤 실제 수익을 모두 더할 때까지 기다리는 대신, 실제로 받은 이번 보상과 다음 상태의 현재 추정값을 결합해 곧바로 갱신합니다.
모르는 길을 가면서 가장 좋은 길 배우기
현재 Q 값이 가장 큰 행동만 계속 선택하면 이미 아는 길은 이용할 수 있지만 가 보지 않은 길의 가치는 알 수 없습니다. 특히 처음에는 모든 값이 0이어서 네 방향을 구분하지 못합니다. 좋은 행동을 고르는 활용(exploitation)과 다른 행동을 시험하는 탐색(exploration)이 모두 필요합니다.
학습 중에는 엡실론 탐욕 정책(epsilon-greedy policy)을 사용합니다. 확률 $\varepsilon$로 네 행동 중 하나를 무작위로 고르고 나머지 확률 $1-\varepsilon$로 현재 Q 값이 가장 큰 행동을 고릅니다.[1][2]
이 구현의 엡실론은 1.0에서 시작합니다. 초반에는 거의 무작위로 움직여 여러 상태와 행동을 경험합니다. 에피소드마다 0.999를 곱해 줄이되 최소 0.05는 유지합니다. Q 값이 같은 행동이 여러 개일 때도 그중 하나를 무작위로 선택합니다. 모든 값이 0인 초기에 늘 첫 번째 행동인 왼쪽만 고르는 편향을 피하기 위해서입니다. 행동 선택 함수와 탐색 확률 계산에서 확인할 수 있습니다.
행동은 엡실론 탐욕 정책으로 선택하지만 갱신 목표에는 실제 다음 행동의 Q 값이 아니라 $\max_{a’}Q(s’,a’)$를 넣습니다. 탐색 때문에 다음에는 엉뚱한 방향으로 움직일 수 있어도, 갱신할 때는 다음 상태에서 가장 좋은 행동을 할 것이라고 봅니다. 경험을 모으는 정책과 배우려는 정책이 다르기 때문에 Q 학습을 오프폴리시(off-policy) 방법이라고 합니다.
학습을 마친 정책을 평가할 때는 탐색을 끄고 Q 표도 더 이상 고치지 않습니다. 평가 코드는 매번 Q 값이 가장 큰 행동을 선택하며 값이 같으면 일정한 순서로 고릅니다. 학습 중의 성공률과 완성된 정책의 성공률을 구분해야 하는 이유입니다.
한 에피소드의 학습 흐름을 모으면 다음과 같습니다.
- 환경을 초기화해 시작 상태를 받습니다.
- 엡실론 탐욕 정책으로 행동을 고릅니다.
- 행동해서 보상, 다음 상태, 종료 여부를 받습니다.
- 이번 보상과 다음 상태의 가장 큰 Q 값으로 목표값을 만듭니다.
- 시간차 오차의 일부만큼 방금 선택한 Q 값을 고칩니다.
- 다음 상태로 옮겨 가고 에피소드가 끝날 때까지 반복합니다.
다음 에피소드도 같은 Q 표에서 시작합니다. 환경은 출발점으로 돌아가지만 앞선 시행착오로 고친 값은 남습니다. 충분히 여러 상태와 행동을 방문해야 유용한 정책을 얻을 수 있는 이유입니다.
학습률·할인율·엡실론은 무엇을 바꿀까?
세 값은 각각 다른 역할을 맡습니다.
| 값 | 이 구현의 설정 | 결정하는 것 | 값을 크게 하면 |
|---|---|---|---|
| 학습률 $\alpha$ | 0.1 | 새 경험을 현재 Q 값에 얼마나 반영할지 | 최근 경험 쪽으로 더 크게 움직입니다. |
| 할인율 $\gamma$ | 0.99 | 다음 상태 이후의 보상을 얼마나 현재 가치로 인정할지 | 먼 미래의 보상도 덜 깎아서 봅니다. |
| 엡실론 $\varepsilon$ | 1.0에서 0.05까지 감소 | 무작위 행동을 얼마나 자주 시도할지 | 더 많이 탐색합니다. |
학습률은 한 번의 수정 폭을 정합니다. 너무 크면 개별 경험에 크게 흔들릴 수 있고 너무 작으면 값이 천천히 변합니다. 할인율이 0이면 다음 상태의 값을 전혀 보지 않아 즉시 보상만 배웁니다. 1에 가까울수록 먼 보상을 중요하게 여기지만 이 예제처럼 매 이동마다 할인을 적용하면 짧은 경로가 더 높은 값을 얻습니다.
엡실론은 Q 값의 의미를 바꾸지 않고 어떤 경험을 모을지를 바꿉니다. 너무 빨리 줄이면 우연히 먼저 발견한 길에 머물 수 있습니다. 계속 크게 유지하면 여러 길을 경험하지만 학습 중에는 좋은 길을 알고도 자주 벗어납니다. 그래서 이 구현은 초반에 넓게 탐색하고 뒤로 갈수록 활용을 늘립니다.
학습 중 성공률은 어떻게 변할까?
에피소드 하나의 성공 여부는 0 또는 1이라 그대로 그리면 변화의 흐름을 읽기 어렵습니다. 아래 그래프의 위쪽은 최근 250회 에피소드의 성공률을 이동 평균으로 계산한 결과입니다. 옅은 세 선은 시드 0, 1, 2의 결과이고 굵은 선은 세 결과의 평균입니다. 가운데에는 시드 0이 성공한 에피소드의 평균 이동 횟수를, 아래에는 같은 시점의 엡실론을 표시했습니다.
시드 0은 TensorBoard 이벤트에서, 시드 1과 2는 Hugging Face에 공개한 training.csv에서 읽었습니다. 각 시드는 10,000회 학습했습니다. TensorBoard의 run/config에는 코드 커밋이 없으므로 동일 로그를 만드는 아래 명령은 96c8605로 고정했습니다.
초반에는 Q 표가 모두 0이고 엡실론도 1에 가까워 움직임이 거의 무작위입니다. 성공을 반복해서 경험하면 목표 근처부터 Q 값이 쌓이고, 그 값이 출발점 쪽으로 전해지면서 최근 성공률이 올라갑니다. 동시에 엡실론이 줄어들어 이미 배운 행동을 선택하는 비율도 커집니다.
가운데 선도 같은 변화를 보여줍니다. 초반에는 성공하더라도 여러 칸을 돌아서 목표에 도착하지만 학습이 진행되면서 평균 이동 횟수가 최단 경로인 6회에 가까워집니다. 엡실론은 2,996번째 에피소드부터 최솟값 0.05를 유지하므로 그 뒤에도 무작위 탐색 때문에 이동 횟수가 조금씩 흔들립니다.
그래프의 학습 성공률은 끝까지 100%에 고정되지 않습니다. 엡실론을 최소 0.05로 유지하므로 학습 중에는 좋은 경로를 배운 뒤에도 5%의 확률로 무작위 행동을 시도하기 때문입니다. 아래 결과 표의 100%는 탐색을 끄고 완성된 정책만 평가한 성공률입니다. 학습 중 성공률과 정책 평가 성공률은 서로 다른 값을 측정합니다.
TensorBoard에서 같은 흐름 확인하기
시드 0으로 10,000회 학습한 TensorBoard 로그에는 에피소드마다 return, length, epsilon, success, terminated, truncated가 기록되어 있습니다. 성공 여부와 엡실론을 같은 에피소드 번호에서 비교하면 탐색이 줄어드는 동안 성공률이 얼마나 안정되는지 확인할 수 있습니다. run/config에는 FrozenLake-v1, is_slippery=False, 학습률 0.1, 할인율 0.99가 들어 있습니다. 실행 당시의 Python·Gymnasium·NumPy·TensorBoard 버전도 이곳에 함께 저장됩니다.
TensorBoard 기록 기능이 포함된 커밋 96c8605를 체크아웃하면 다음과 같이 같은 로그를 만들고 확인할 수 있습니다.
git checkout --detach 96c86057875d93dd6450a19f9a6079fc3e56679d
uv sync --locked --extra tensorboard
uv run --locked --extra tensorboard python -m environments.toy_text.frozen_lake train --seed 0 --episodes 10000 --tensorboard --tensorboard-run-name local-seed0-10000
uv run --locked --extra tensorboard tensorboard --logdir runs/frozen_lake/tensorboard
TensorBoard 로그에는 학습 과정이 담깁니다. 학습된 정책은 q_table.npy에 들어 있으므로 로그가 없어도 평가하거나 재생할 수 있습니다.
terminated와 truncated를 구분하는 이유
Gymnasium은 에피소드가 멈춘 이유를 terminated와 truncated로 나눕니다. 목표에 도착하거나 구멍에 빠져 환경의 과제가 끝나면 terminated=True입니다. 더 이어질 상태가 없으므로 Q 학습의 목표값에 다음 상태의 값을 더하지 않습니다.
100번 이동해서 시간 제한에 걸리면 truncated=True입니다. 과제 자체가 끝난 것이 아니라 경험 수집을 잘라 낸 것입니다. 이번 구현의 상태에는 남은 이동 횟수가 포함되지 않으므로 시간 제한 직전의 칸도 평소와 같은 칸으로 취급하고 다음 상태의 값으로 부트스트래핑합니다. 두 경우 모두 현재 에피소드의 반복은 멈추지만 Q 값의 목표를 계산하는 방식은 다릅니다.
학습한 정책은 무엇을 보여줄까?
난수의 시작값인 시드(seed)를 0, 1, 2로 바꿔 각각 10,000회 학습하고 학습한 정책과 무작위 정책을 각각 1,000회 평가했습니다. 평가 시드는 순서대로 10000, 10001, 10002를 사용했습니다. 아래는 커밋 4a14295를 2026년 9월 7일 macOS ARM64에서 Python 3.13.15, Gymnasium 1.3.0, NumPy 2.5.3으로 실행한 결과입니다.
| 학습 시드 | 학습한 정책의 성공률 | 성공까지 평균 이동 횟수 | 무작위 정책의 성공률 |
|---|---|---|---|
| 0 | 100% | 6회 | 1.5% |
| 1 | 100% | 6회 | 1.2% |
| 2 | 100% | 6회 | 1.1% |
세 경우 모두 학습한 정책은 구멍을 피해 6번 이동해 목표에 도착했습니다. 출발점에서 목표까지는 오른쪽으로 3칸, 아래로 3칸만큼 이동해야 하므로 6회는 가능한 최소 이동 횟수입니다. 무작위 정책은 같은 조건에서 약 1%만 성공했습니다. Q 표는 성공하는 행동 중에서도 짧게 성공하는 행동을 구분해 정책으로 만들었습니다.
학습된 세 Q 표와 학습 이력은 Hugging Face 모델 저장소에 공개했습니다. 각 시드의 디렉터리에는 16 × 4 크기의 q_table.npy와 config.json, training.csv, evaluation.json이 들어 있습니다. 업로드한 Q 표를 다시 평가한 결과도 위 표와 일치했습니다. 같은 파일을 내려받으려면 Hub 커밋 b221cf5를 지정합니다.
이 결과는 Q 학습의 일반적인 성공률을 뜻하지 않습니다. 미끄러지지 않는 고정 지도에서 출발점과 목표가 항상 같고 평가 중에는 행동도 고정되어 같은 경로를 반복합니다. 여기서 나온 100%를 새로운 지도나 미끄러운 얼음에 그대로 적용할 수는 없습니다. 이번 실험에서 확인한 결과는 주어진 4×4 환경의 Q 표가 최단 성공 정책을 만든다는 사실입니다.
직접 실행하고 영상으로 보기
학습된 Q 표 바로 실행하기
학습 과정을 건너뛰고 Hugging Face에 올린 Q 표를 불러와 평가하거나 화면으로 재생할 수도 있습니다. 다음 명령은 재현성을 위해 모델 불러오기를 지원하는 코드 커밋 96c8605와 Hub 커밋 b221cf5를 함께 고정합니다.
git clone https://github.com/ruddyscent/gymnasium-playbook.git gymnasium-playbook-frozen-lake
cd gymnasium-playbook-frozen-lake
git checkout --detach 96c86057875d93dd6450a19f9a6079fc3e56679d
uv sync --locked --extra hub
uv run --locked --extra hub python -m environments.toy_text.frozen_lake evaluate --hub-repo ruddyscent/gymnasium-playbook-frozenlake-q-learning --hub-revision b221cf51b99a9ba07cb9d3de65430acdb94162a7 --hub-seed 0 --episodes 1000 --seed 10000
uv run --locked --extra hub python -m environments.toy_text.frozen_lake watch --hub-repo ruddyscent/gymnasium-playbook-frozenlake-q-learning --hub-revision b221cf51b99a9ba07cb9d3de65430acdb94162a7 --hub-seed 0
프로그램은 Hub에서 받은 config.json을 읽어 환경과 최대 이동 횟수를 맞춘 뒤 q_table.npy로 행동을 고릅니다. 이 파일은 신경망의 가중치가 아니라 64개의 행동 가치를 담은 NumPy 배열입니다. 저장된 표로 평가와 재생은 할 수 있지만 난수 생성기 상태가 없으므로 중단한 학습을 그대로 이어 갈 수는 없습니다.
직접 학습하기
이 글의 구현 설명과 실행 명령은 커밋 4a14295를 기준으로 합니다. 같은 버전으로 실행하려면 저장소를 별도 디렉터리에 복제한 뒤 해당 커밋을 체크아웃합니다.
git clone https://github.com/ruddyscent/gymnasium-playbook.git gymnasium-playbook-frozen-lake
cd gymnasium-playbook-frozen-lake
git checkout --detach 4a142954fb52ef8e052257407d85a1d7884d9af3
해당 커밋의 환경 준비 안내에 따라 uv와 Python을 준비한 뒤 같은 디렉터리에서 다음 명령을 실행합니다.
uv sync --locked
uv run --locked python -m environments.toy_text.frozen_lake train --seed 0
uv run --locked python -m environments.toy_text.frozen_lake watch --q-table runs/frozen_lake/seed-0/q_table.npy
학습 결과는 runs/frozen_lake/seed-0/q_table.npy에 저장됩니다. watch는 저장한 표로 행동을 재생합니다. 창을 띄울 수 있는 환경에서 실행하며 기본 속도는 초당 두 번 이동입니다. 창을 닫거나 Escape를 누르면 종료됩니다.
같은 조건에서 성공률을 비교하려면 다음 명령을 실행합니다. 결과는 runs/frozen_lake/benchmark/summary.csv와 summary.json에 남습니다. 자세한 실행 옵션은 FrozenLake 실행 안내에 정리되어 있습니다.
uv run --locked python -m environments.toy_text.frozen_lake benchmark --seeds 0 1 2 --episodes 10000 --eval-episodes 1000 --eval-seed 10000
실행 영상은 아래 YouTube 링크에서도 볼 수 있습니다.
YouTube에서 FrozenLake 영상과 재생목록 열기
함께 보기
- Richard S. Sutton, Andrew G. Barto. Reinforcement Learning: An Introduction, 2판. MIT Press, 2018. 탐색과 엡실론 탐욕 선택은 §2.2 “Action-value Methods”(27쪽), 할인된 보상과 에피소드는 §3.3 “Returns and Episodes”(54쪽), 정책과 가치 함수는 §3.5 “Policies and Value Functions”(58쪽), Q 학습의 갱신식은 §6.5 “Q-learning: Off-policy TD Control”(131쪽)을 참고합니다. 쪽수는 인쇄본 기준이며 공식 목차에서도 해당 절을 찾을 수 있습니다.
- University of Alberta · Coursera. Reinforcement Learning Specialization의 1번째 강좌, Fundamentals of Reinforcement Learning. “An Introduction to Sequential Decision-Making” 단원의 「Learning Action Values」, 「What is the trade-off?」와 탐색 실습에서 행동의 가치 추정과 엡실론 탐욕 선택을 다룹니다. “Value Functions & Bellman Equations” 단원의 「Specifying Policies」, 「Value Functions」는 본문의 정책과 Q 값 설명에 해당합니다.
- University of Alberta · Coursera. Reinforcement Learning Specialization의 2번째 강좌, Sample-based Learning Methods. “Temporal Difference Learning Methods for Prediction” 단원의 「What is Temporal Difference (TD) learning?」에서 다음 상태의 추정값을 이용하는 갱신을 설명합니다. “Temporal Difference Learning Methods for Control” 단원의 「What is Q-learning?」, 「How is Q-learning off-policy?」는 탐색하면서도 다음 상태의 최댓값을 목표로 학습하는 원리를 설명합니다.
- Udacity. Deep Reinforcement Learning, Course 1: Introduction to Deep Reinforcement Learning. 「The RL Framework: The Problem」과 「The RL Framework: The Solution」에서 문제와 해법의 기본 틀을, 「Temporal-Difference Methods」에서 Q 학습을 다룹니다. 공식 강의 실습 저장소에는 Q 학습을 직접 구현하는 연습도 있습니다.